 アプリケーション側の作業
ステップ 1
アプリケーション開発者
開発者は、アプリケーションからのリクエストを受け取り、モデルを呼び出して、結果をユーザーに返すバックエンドサービスを必要とする場合があります。Baseten は、その一連の処理のうちモデルのサービングを担います。周辺のインターフェース、エラーメッセージ、モデルをいつ呼び出すかの判断は、引き続きアプリケーション側の仕事です。
- アプリケーションのコードをモデル推論に接続する
- リクエストが失敗した場合の動作を設計する
プラットフォームの概要
basetenは何をするものかというと、簡単に言えば、BasetenはAIモデルのデプロイと提供に必要なインフラを提供します。チームがモデルをアプリケーションから利用できる推論サービスにするのを支援し、提供基盤を一から構築する必要をなくします。
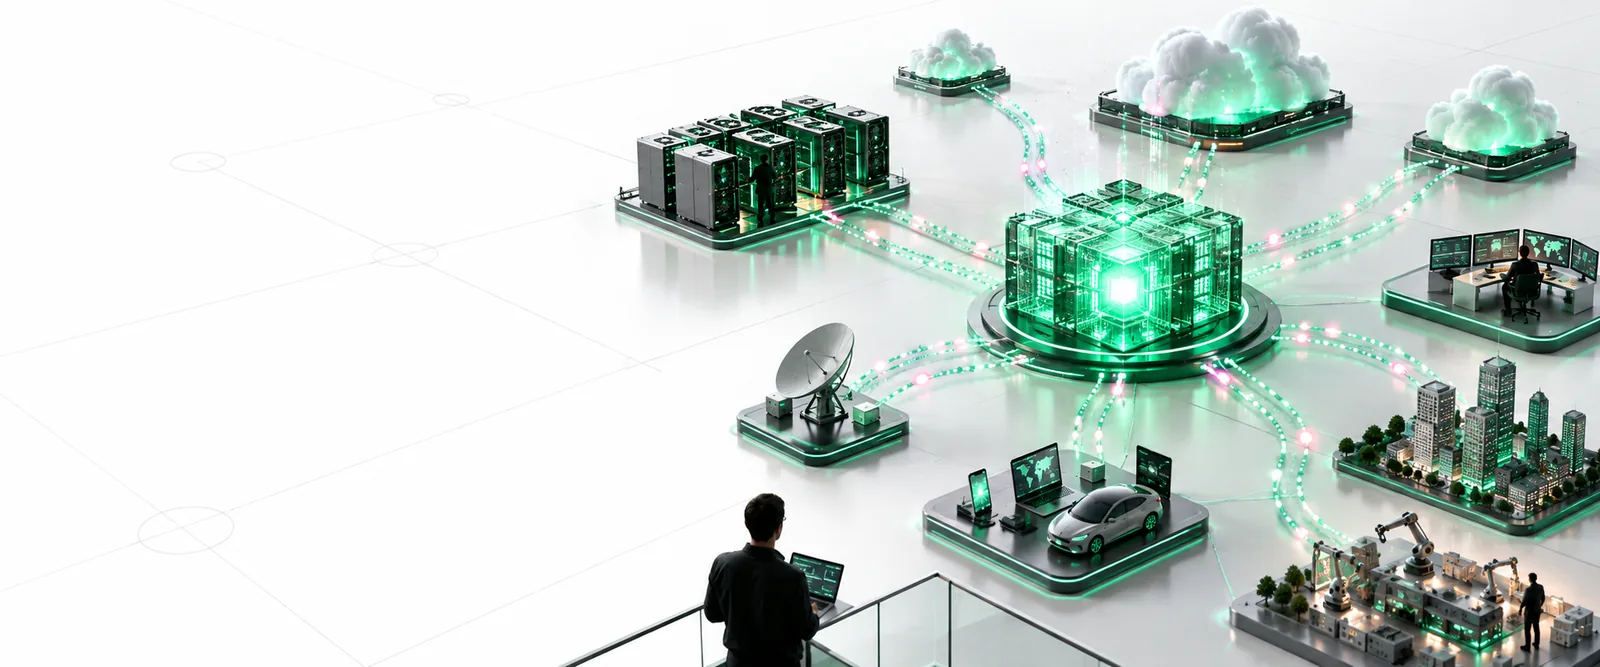
Basetenは、モデルをアプリケーションで活用することに重点を置いたAIインフラプラットフォームです。その中核となる役割はモデルの提供です。リクエストを受け取り、モデルを実行し、結果を返します。
目的Basetenは、チームがAIモデルをアプリケーションから呼び出せるサービスとしてデプロイするのを支援します。
この定義は出発点です。以下のガイドでは、プラットフォームへのアクセス方法、推論ワークフローの進め方、データを送信する前に評価すべき点を説明します。
モデルサービングは、既存のモデルを、その予測や生成結果を必要とするソフトウェアにつなぎます。具体的な構成はモデルとアプリケーションによって異なります。
チームは実行するモデルを選び、入力と出力の要件を決めます。たとえば、テキストモデルと画像モデルではリクエストの形式が異なります。
推論インフラストラクチャを通じてモデルを利用できるようにします。このインフラストラクチャは、リクエストの受け付けやデプロイ済みモデルの実行といった運用作業を担います。
アプリケーションのコードがエンドポイントに入力を送り、返された出力を利用します。チームは引き続き、応答品質のテスト、エラーへの対処、結果が要件を満たしているかの監視を行う必要があります。
Basetenはサービング層を提供できますが、モデルのサービングは、モデルの選定、評価、ガバナンスとは別です。推論プロジェクトには、次の実務上の要件があります。
明確に定義されたタスクと、そのタスクに適したモデル — インフラストラクチャだけでは、モデルが有用で信頼できる回答を返すかどうかは判断できません。
アプリケーションが処理できる入力と想定される出力 — アプリケーションは、何を送信し、応答をどう利用または却下するかを把握している必要があります。
品質、障害、データの取り扱いに関するテスト計画 — デプロイは、評価や機密情報の取り扱いに関する確認の代わりにはなりません。
モデルを取り巻く独自のアプリケーション機能任意 — ユーザーインターフェースや業務ワークフローが必要になる場合もありますが、それらは推論サービングとは別です。
Basetenは、完成済みのチャットアプリや画像編集アプリを探している人よりも、AIモデルを呼び出すソフトウェアを開発するチームに適しています。
アプリケーション側の作業
ステップ 1
開発者は、アプリケーションからのリクエストを受け取り、モデルを呼び出して、結果をユーザーに返すバックエンドサービスを必要とする場合があります。Baseten は、その一連の処理のうちモデルのサービングを担います。周辺のインターフェース、エラーメッセージ、モデルをいつ呼び出すかの判断は、引き続きアプリケーション側の仕事です。
 モデルの運用
ステップ 2
こうしたチームには、ほかのサービスから利用できるようにしたいモデルがあるかもしれません。Baseten は、デプロイと推論に利用を検討できるインフラを提供します。一方、モデルの選定、動作の確認、組織の要件を満たしているかどうかの判断は、引き続きチームの責任です。有望な実験を信頼できるアプリケーションへと発展させる際には、この役割分担が重要になります。
Baseten の役割を理解すると、モデルのサービングと、その周囲に構築されるモデルやアプリケーションを区別しやすくなります。AI ツールをさらに幅広く探している場合、以下のリンクから別のサービスである Synexa を開けます。Baseten のデプロイコンソールではありません。
Baseten は、AI モデルのデプロイとサービングのためのインフラを提供します。具体的には、チームがアプリケーションからの推論リクエストにモデルで応答できるよう支援します。
モデルのサービングとアプリケーション開発は別の仕事です。Baseten はモデルの実行に使うインフラを担い、ユーザーがモデルとどのようにやり取りするか、モデルの出力をどう扱うかは、アプリケーションを開発するチームが決めます。
いいえ。デプロイによって推論は可能になりますが、モデルの出力が想定するタスクに適しているかは、引き続きテストする必要があります。チームは品質、失敗するケース、データの取り扱いに関する要件を評価しなければなりません。
アプリケーションは、デプロイされたモデルに適した入力を含む推論リクエストを送信します。モデルは、アプリケーションが処理したりユーザーに表示したりできる出力を生成します。具体的な入力と出力はモデルによって異なります。