API de modelos preoptimizados
Crea prototipos de productos y evalúa modelos de IA mediante una API lista para inferencia.
Explora los modelosExplora una inferencia de IA rápida y flexible.
Sirve modelos de IA de código abierto, personalizados y ajustados en una infraestructura diseñada para cargas de trabajo de producción a gran escala.
Crea prototipos de productos y evalúa modelos de IA mediante una API lista para inferencia.
Explora los modelosDesarrolla modelos y pasa de la experimentación a la inferencia en producción.
Más informaciónLleva modelos especializados a las aplicaciones y los equipos que los necesitan.
Más información
Requiere infraestructura, herramientas y experiencia para llevar al mercado productos de IA ambiciosos.
Los kernels personalizados, las técnicas de decodificación y el almacenamiento en caché también importan al hablar de inferencia en producción.
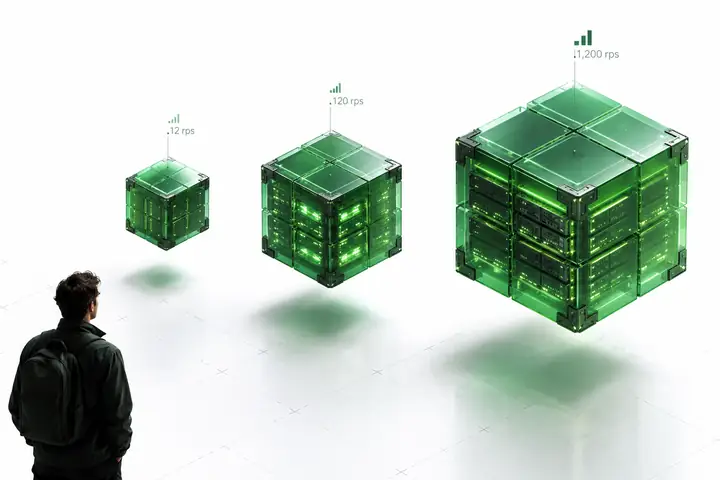
Ten en cuenta distintas nubes y regiones al elegir dónde ejecutar las cargas de trabajo de producción.
Despliega, gestiona y perfecciona modelos con un flujo de trabajo centrado en los desarrolladores.
El apoyo directo de ingeniería puede ayudar a los equipos a pasar de prototipos a sistemas de producción.
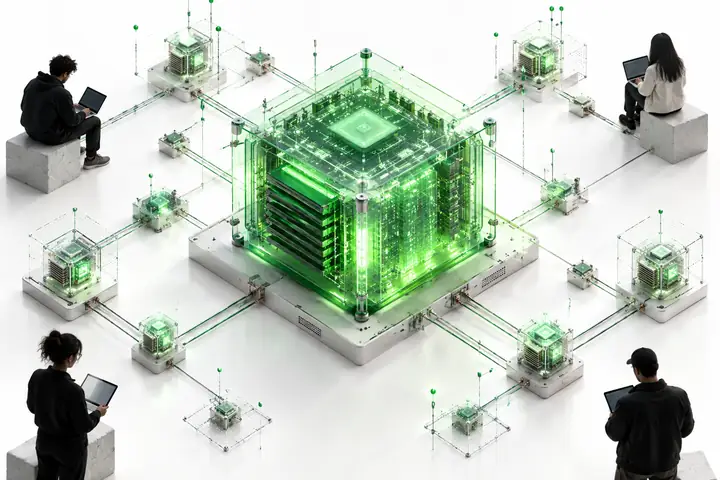
Elige opciones de despliegue que se adapten a las necesidades de capacidad, control y seguridad de tu carga de trabajo.
Una opción de despliegue gestionado para equipos que quieren centrarse en sus modelos y aplicaciones.
Explorar la nubeUna opción para equipos que evalúan la inferencia dentro de su propia infraestructura.
Más informaciónCada aplicación de IA tiene necesidades de rendimiento distintas en toda la pila de inferencia.
Ejecuta modelos de imagen y flujos de trabajo creativos para generar imágenes de alta calidad.
La transcripción y los flujos de trabajo de audio que distinguen entre hablantes plantean exigencias específicas para la inferencia.
La voz en streaming puede impulsar agentes de voz, conversaciones y experiencias de traducción.
Los modelos de lenguaje en producción requieren prestar especial atención al rendimiento y la latencia.
Las cargas de trabajo de embeddings se benefician de un enfoque de inferencia adaptado a sus características.
Los sistemas de IA de varias etapas combinan decisiones sobre modelos y orquestación.
Explora las opciones de despliegue para modelos personalizados y propietarios, junto con las herramientas necesarias para llevarlos a producción.
«La experiencia de nuestros usuarios y el soporte que respalda nuestro producto son igual de importantes».
Perspectiva del cliente · Zed
«Tener más control sobre el proceso de inferencia hace que cada paso de optimización cuente».
Perspectiva del cliente · Wispr
«La velocidad importa cuando un producto de IA apoya tareas en las que cada momento cuenta».
Perspectiva del cliente · OpenEvidence
«Una inferencia fiable y escalable ayuda a que la conversión de voz a texto sea útil en los flujos de trabajo cotidianos».
Perspectiva del cliente · ClickUp
«Nuestros equipos pueden centrarse en los modelos y las experiencias que distinguen a nuestro producto».
Perspectiva del cliente · Writer