API de modèles préoptimisés
Créez des prototypes de produits et évaluez des modèles d’IA grâce à une API prête pour l’inférence.
Explorer les modèlesDécouvrez une inférence IA rapide et flexible.
Déployez des modèles d’IA open source, personnalisés et affinés sur une infrastructure conçue pour les charges de travail de production à grande échelle.
Créez des prototypes de produits et évaluez des modèles d’IA grâce à une API prête pour l’inférence.
Explorer les modèlesDéveloppez des modèles et passez de l’expérimentation à l’inférence en production.
En savoir plusMettez des modèles spécialisés à la disposition des applications et des équipes qui en ont besoin.
En savoir plus
Il faut une infrastructure, des outils et une expertise pour lancer des produits d’IA ambitieux sur le marché.
Les noyaux personnalisés, les techniques de décodage et la mise en cache sont essentiels à l’inférence en production.
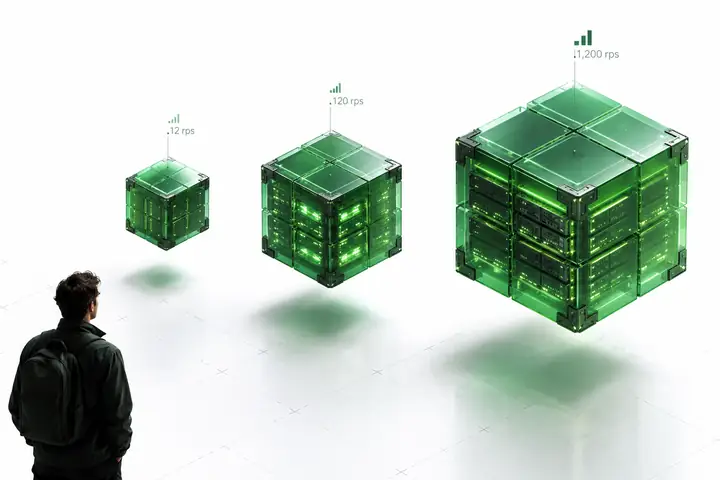
Tenez compte des clouds et des régions pour choisir où exécuter vos charges de travail en production.
Déployez, gérez et perfectionnez vos modèles grâce à un workflow pensé pour les développeurs.
Un accompagnement technique concret peut aider les équipes à passer des prototypes aux systèmes de production.
Choisissez les options de déploiement adaptées aux besoins de capacité, de contrôle et de sécurité de votre charge de travail.
Une solution de déploiement gérée pour les équipes qui souhaitent se concentrer sur leurs modèles et leurs applications.
Explorer le cloudUne option pour les équipes qui évaluent l’inférence au sein de leur propre infrastructure.
En savoir plusLes applications d’IA ont des exigences de performance différentes à chaque niveau de la pile d’inférence.
Déployez des modèles d’image et des workflows créatifs conçus pour générer des visuels de haute qualité.
La transcription et les workflows audio qui distinguent les locuteurs imposent des exigences particulières à l’inférence.
La diffusion vocale en continu peut prendre en charge les agents vocaux, les conversations et les expériences de traduction.
Les modèles de langage en production exigent une attention particulière au débit et à la latence.
Les charges de travail d’embedding bénéficient d’une approche de l’inférence adaptée à leurs caractéristiques.
Les systèmes d’IA à plusieurs étapes combinent plusieurs choix de modèles et d’orchestration.
Explorez les options de déploiement pour les modèles personnalisés et propriétaires, ainsi que les outils nécessaires à leur mise en production.
« L’expérience de nos utilisateurs et le soutien apporté à notre produit comptent tous deux. »
Point de vue client · Zed
« Avoir davantage de contrôle sur le pipeline d’inférence permet de tirer le meilleur parti de chaque étape d’optimisation. »
Point de vue client · Wispr
« La rapidité compte lorsqu’un produit d’IA accompagne un travail où chaque instant compte. »
Point de vue client · OpenEvidence
« Une inférence fiable et évolutive aide à rendre la transcription vocale utile dans les flux de travail quotidiens. »
Point de vue client · ClickUp
« Nos équipes peuvent se concentrer sur les modèles et les expériences qui distinguent notre produit. »
Point de vue client · Writer