Rode a fronteira aberta em escala na Baseten
A Baseten une inferência, treinamento e execução de agentes em uma única plataforma, impulsionando as equipes de IA mais ágeis do mundo.
Inferência Dedicada
Execute modelos personalizados com throughput ajustado ao seu tráfego.
APIs de Modelos
Endpoints prontos para modelos abertos de fronteira desde o dia do lançamento.
Treinamento
Faça ajuste fino com seu próprio código ou com o Loops, o SDK da Baseten.
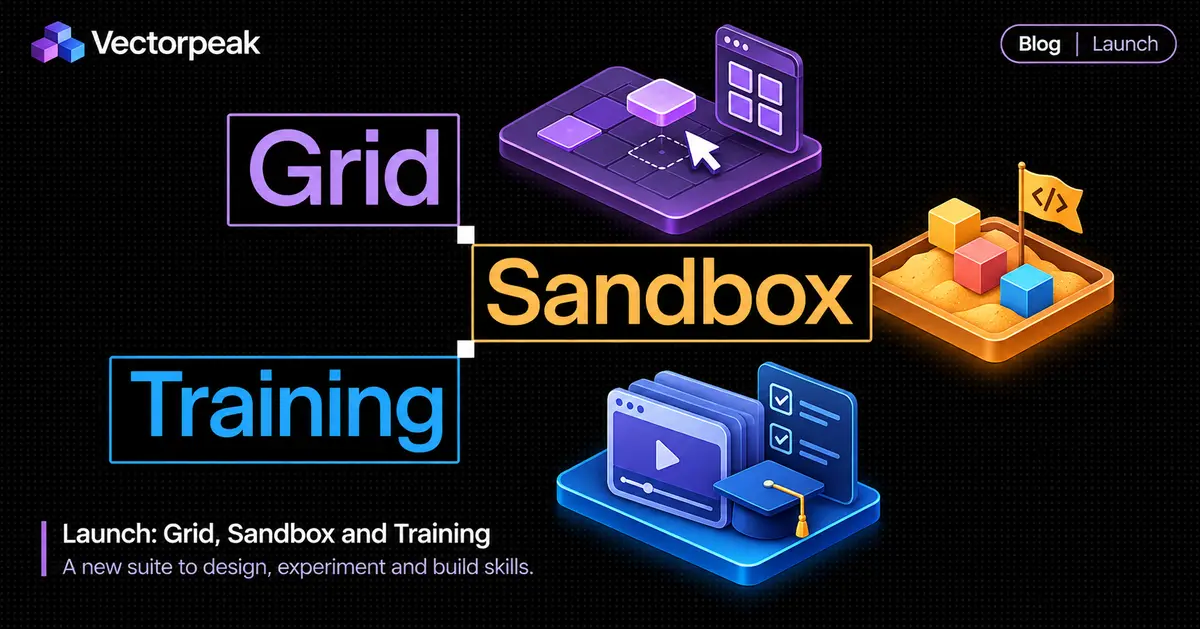
Sandboxes
Runtimes isolados que permitem que os agentes ajam rapidamente.
Grid
Controle o acesso, acompanhe o uso e encaminhe cada solicitação.
Cresça além da fronteira usando inteligência que dura: pesos que você possui, gastos previsíveis e a liberdade de escolher o modelo certo para cada tarefa. A Baseten foi criada para velocidade e disponibilidade, com o apoio de engenheiros que se integram como parte da sua equipe.
:: Nossos produtos
Feito para toda carga de trabalho de IA
 Inferência Dedicada
Sirva modelos personalizados na Baseten com desempenho moldado para sua carga de trabalho.
Cliente em destaque
Ledgerline
A Baseten nos permite executar várias famílias de modelos lado a lado, então minha equipe passa o tempo escolhendo a opção certa, e não cuidando de GPUs.
Priya Natarajan, VP de Engenharia
Conheça a Inferência Dedicada APIs de Modelos
Endpoints de nível de produção para modelos abertos de ponta desde o primeiro dia.
Cliente em destaque
Quillstack
Mudamos para um novo modelo aberto na manhã em que foi lançado. A Baseten tinha o endpoint no ar antes do standup terminar.
Daniel Okafor, Head de IA
APIs de Modelos Abertos Treinamento
Treine com seu próprio código ou com o Loops, o SDK de treinamento da Baseten.
Cliente em destaque
Fernwood Labs
O ajuste fino e a disponibilização em um só lugar reduziram nosso ciclo de iteração de semanas para dias.
Elena Varga, Líder de ML
Explorar Treinamento Sandboxes
Ambientes de execução seguros que dão aos agentes liberdade para avançar rápido.
Cliente em destaque
Tidepool
Nossos agentes criam ambientes isolados na Baseten em segundos, sem vizinhos barulhentos com que se preocupar.
Marcus Chen, CTO
Experimente Sandboxes Grid
Uma camada de controle para governar o acesso, acompanhar o uso e rotear solicitações.
Cliente em destaque
Northgate Bank
O Grid nos deu uma visão única de cada chamada de modelo, e nossos gastos com IA finalmente têm um teto.
Sofia Reyes, Diretora de Plataforma
Descubra o GridMantenha-se onlinequando os riscos são maiores.
A Baseten oferece 99.99% de uptime com infraestrutura reforçada, capacidade em diversas nuvens e failover automático que resiste a indisponibilidades.
Clarion Health
A busca com IA da Clarion Health oferece aos profissionais de saúde respostas médicas rápidas, precisas e atualizadas diretamente à beira do leito.
"Bilhões de chamadas de modelos ajustados passam pela Baseten toda semana, colocando orientações clínicas de alta criticidade diante de profissionais de saúde em quase todos os principais sistemas hospitalares. É provável que seu médico tenha usado isso hoje de manhã."
- 160ms
- Latência de ida e volta
- 6x
- Implantações mais rápidas
:: Mais do blog
Harborline
"Desde que migramos para a Baseten, pensamos muito menos em serving e capacidade, e muito mais na qualidade do que nossos modelos retornam."
:: Mais histórias de clientes
Atlas Research
A Atlas Research impulsiona a due diligence de gestores de ativos, banqueiros e equipes da Fortune 500 que enfrentam grandes decisões.
"A latência foi o que nos trouxe à Baseten. Nossas cargas de trabalho têm picos intensos, e os clientes nunca se importam em qual fila estamos presos."
:: Mais casos de clientes
Meridian Web
"Modelos abertos igualam modelos fechados pequenos em nossas tarefas por cerca de um terço do preço. O roteamento com reconhecimento de cache na Baseten mantém cada turno aquecido, então a economia se mantém."
:: Mais casos de clientes
Paperkite
"Com a Baseten, nossos modelos entraram em produção em dias, não em meses."
:: Mais histórias de clientes
:: Comece agora
Pronto em qualquer escala.
Rápido desde o primeiro dia.
- 99.99%
- Disponibilidade
- 30+
- Parceiros de nuvem
- 15.5B+
- Chamadas de inferência por dia